Le Blog
Le hasard maîtrisé : température, top-k, top-p
SérieDu token au chatbotÉpisode 3 sur 3
- 🎯 Objectifs d’apprentissage
- 🧭 Prérequis et préparation
- 🗺️ Vue d’ensemble : où on agit aujourd’hui
- PARTIE A — Déterministe ou aléatoire : pourquoi échantillonner
- PARTIE B — La température : le curseur créativité (LE CŒUR)
- PARTIE C — Top-k et top-p : filtrer avant de tirer
- PARTIE D — Bonus : sens les réglages sur un vrai modèle (GPU facultatif)
- ⚠️ Pièges fréquents (récapitulatif transversal)
- 🔁 Récap final synthétique
- ✅ Quiz de validation
- 🔧 Si ça coince (dépannage)
- 🚀 Pour aller plus loin
Épisode 3 de la série « Du token au chatbot » — un parcours pratique qui va de la mécanique interne d’un LLM jusqu’à construire son propre chatbot.
Depuis le premier épisode, une question est restée en suspens. Tu sais que le modèle produit une liste de probabilités pour le prochain mot (épisode 1), et tu sais comment il la calcule en faisant circuler le sens par l’attention (épisode 2). Mais on a toujours choisi le mot avec
argmax— « prends toujours le plus probable » — ce qui donne un modèle déterministe et souvent répétitif. Or ChatGPT te répond différemment à chaque fois, avec créativité. Aujourd’hui, tu découvres comment on choisit réellement le mot dans la liste : les trois réglages — température, top-k, top-p — qui pilotent l’équilibre entre rigueur et créativité. Et tu vas les sentir de l’intérieur, sur ta machine.
📌 Pour qui : tu sors des deux premiers épisodes (tokens, embeddings, logits, softmax, attention, boucle autorégressive). Le seul outil maths mobilisé aujourd’hui est le softmax (épisode 2, Partie 0.3) — on en fera un rappel ciblé. Aucune nouvelle charge mathématique lourde.
💻 Prérequis matériel : les manips de base (Parties A à C) tournent en CPU sur n’importe quel ordinateur récent — on manipule de petites distributions pour comprendre. Une Partie D bonus (facultative) fait sentir les réglages sur un vrai modèle moderne (Qwen2.5-1.5B) : un GPU NVIDIA compatible CUDA la rend fluide, mais elle reste faisable en CPU (simplement plus lente). On reste sur
uvet le projetllm-formation.
⏱️ Durée : 2 à 3 h. Découpage conseillé : Parties A + B en session 1 ; C + D en session 2. Tu peux couper après la Partie B (le cœur).
🎯 Objectifs d’apprentissage
À la fin de ce module, tu seras capable de :
- Expliquer la différence entre choix déterministe (
argmax/greedy) et échantillonnage (sampling), et pourquoi ce dernier rend un modèle « créatif ». - Décrire l’effet de la température sur une distribution de probabilités, et prédire ce que font T→0 et T élevée.
- Distinguer top-k et top-p (nucleus), dire ce que chacun coupe, et pourquoi top-p s’adapte mieux.
- Régler ces paramètres dans
generate()de Hugging Face pour obtenir un comportement voulu. - Diagnostiquer un texte généré (trop plat ? incohérent ?) et savoir quel curseur ajuster.
🧠 Garde ces 5 objectifs en tête. À la fin, tu reviendras les cocher.
🧭 Prérequis et préparation
Côté savoir : les acquis des deux premiers épisodes, surtout que la sortie du modèle est une liste de probabilités (via softmax sur les logits) et que argmax prend le maximum.
Côté outils : on réutilise le projet llm-formation. Place-toi dedans :
cd llm-formationPour les manips de base (Parties A à C), NumPy suffit (déjà là depuis les épisodes précédents) :
uv add numpy # ne fait rien s'il est déjà présent : normal💡 Rappel
uv:uv add <paquet>pour une dépendance,uv run <script>.pypour lancer un script dans l’environnement du projet. La version GPU de PyTorch (installée à l’épisode 1, Partie D) resservira en Partie D — mais seulement si tu as un GPU.
⚠️ Section de dépannage en bas (« 🔧 Si ça coince »).
🗺️ Vue d’ensemble : où on agit aujourd’hui
Rappel du pipeline. Aujourd’hui, on ne touche ni au modèle ni à l’attention : on agit uniquement sur la toute dernière étape, le choix du mot dans la liste de probabilités.
   [ ... attention, logits (épisodes 1-2) ... ]
              │
              ▼
   [ SOFTMAX ]  ──►  liste de probabilités : "Paris" 60%, "Lyon" 8%, "the" 5%, ...
              │
              ▼
   ╔══════════════════════════════╗
   ║  CHOIX DU MOT                ║   ◄────  CET ÉPISODE, C'EST ICI
   ║  • greedy (argmax)           ║         comment pioche-t-on dans la liste ?
   ║  • température               ║         → 3 réglages qui changent tout
   ║  • top-k / top-p             ║
   ╚══════════════════════════════╝
              │
              ▼
   [ le mot choisi est ré-injecté -> on recommence (autorégression, épisode 1) ]
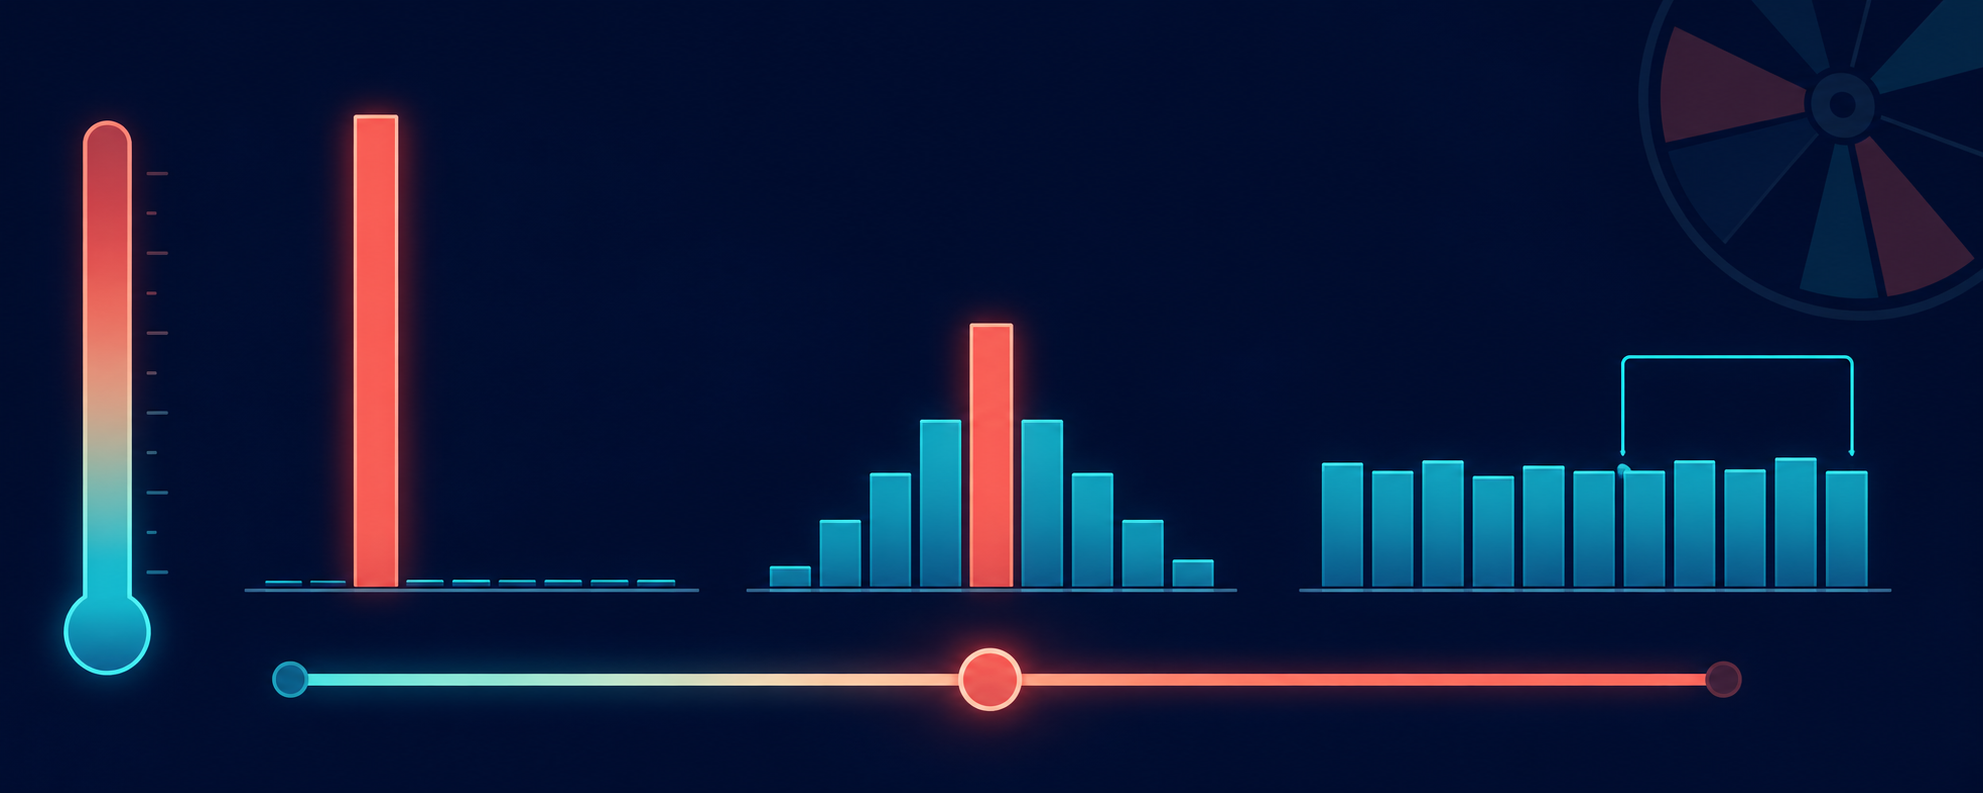
📌 L’idée du jour en une phrase : la liste de probabilités ne change pas ; ce qui change, c’est la règle de tirage. La rendre plus ou moins « aventureuse » revient à déplacer un curseur entre fiabilité et créativité.
📌 Comment lire la suite : quatre parties.
- Partie A — déterministe vs aléatoire : pourquoi échantillonner. Point de départ.
- Partie B — la température, cœur du réglage : tu la recodes. Le cœur.
- Partie C — top-k et top-p : filtrer avant de tirer.
- Partie D — bonus : sentir les réglages sur un vrai modèle (Qwen), sur ton GPU si tu en as un.
🧵 Notre fil rouge (suite des deux premiers épisodes) : « Paris »
On garde l’exemple. Après « The capital of France is », le modèle a produit une liste où « Paris » domine largement. Question du jour :
Selon la règle de tirage choisie, va-t-on toujours sortir « Paris », ou parfois autre chose ? Et sur une phrase créative comme « Once upon a time », comment éviter à la fois le texte plat ET le charabia ?
PARTIE A — Déterministe ou aléatoire : pourquoi échantillonner
A.1 — Le rappel : greedy, et son défaut
❓ Question d’ouverture : à l’épisode 1,
argmaxprenait toujours le mot le plus probable. Quel était son défaut observé sur « Once upon a time » ?
Le constat
argmax (stratégie greedy, « gloutonne ») choisit systématiquement le mot de plus haute probabilité. Conséquences :
- Déterministe : même prompt → exactement la même sortie, à chaque fois.
- Répétitif : tu l’as vu à l’épisode 1, le texte tourne en rond (« very very very… »), car greedy ne s’autorise jamais le moindre écart et retombe dans les mêmes ornières.
Pour un fait précis (« capitale de la France »), c’est parfait : on veut « Paris ». Mais pour écrire, raconter, brainstormer, on veut de la variété. Il faut donc une règle de tirage qui introduit du hasard maîtrisé.
L’analogie : le restaurant
Greedy, c’est commander toujours ton plat préféré, chaque jour, à vie. Fiable, mais tu ne découvriras jamais rien. Échantillonner, c’est parfois prendre ton plat préféré (souvent, car tu l’aimes), parfois le n°2 de la carte, occasionnellement une surprise. Tu gardes une préférence (les plats aimés sortent plus souvent) tout en laissant place à la découverte.
A.2 — Échantillonner : tirer selon les probabilités
❓ Question d’ouverture : comment « tirer au hasard mais en respectant les probabilités » ? Si « Paris » vaut 60 % et « Lyon » 8 %, comment faire pour sortir « Paris » plus souvent, sans jamais totalement exclure « Lyon » ?
L’idée
Échantillonner (sampling), c’est piocher un mot au hasard, mais avec une chance proportionnelle à sa probabilité. « Paris » à 60 % sortira ~6 fois sur 10 ; « Lyon » à 8 % sortira ~8 fois sur 100. On respecte la préférence du modèle sans être rigide.
L’analogie : la roue de loterie
Imagine une roue où chaque mot occupe une part proportionnelle à sa probabilité : « Paris » occupe 60 % de la roue, « Lyon » 8 %, etc. On lance la bille : elle tombe le plus souvent sur les grandes parts, parfois sur les petites. C’est exactement l’échantillonnage.
🔬 Manip 1 — greedy vs échantillonnage, sur une distribution jouet
On fabrique une petite liste de probabilités et on compare les deux stratégies sur 1000 tirages. Crée j3_manip1_greedy_vs_sampling.py :
# j3_manip1_greedy_vs_sampling.py — comparer "toujours le max" et "tirer au hasard pondéré"
import numpy as np

mots   = ["Paris", "Lyon", "the", "France", "banana"]
probas = np.array([0.60, 0.08, 0.05, 0.25, 0.02])   # somme = 1

# --- GREEDY : on prend toujours l'indice de la proba maximale ---
choix_greedy = mots[np.argmax(probas)]
print("GREEDY (argmax) ->", choix_greedy, "(toujours le même)")

# --- ÉCHANTILLONNAGE : on tire 1000 fois selon les probas, et on compte ---
tirages = np.random.choice(mots, size=1000, p=probas)   # p = respecte les probabilités
uniques, comptes = np.unique(tirages, return_counts=True)
print("\nÉCHANTILLONNAGE sur 1000 tirages :")
for mot, c in sorted(zip(uniques, comptes), key=lambda x: -x[1]):
    print(f"   {mot:8} : {c:4d} fois  (~{c/10:.0f} %)")
Lance : uv run j3_manip1_greedy_vs_sampling.py
✅ Checkpoint : greedy sort toujours « Paris ». L’échantillonnage sort « Paris » ~600 fois, « France » ~250 fois, et « banana » quelques fois seulement — proportionnel aux probabilités. Tu vois la différence fondamentale : greedy = 1 réponse figée ; sampling = de la variété qui respecte les préférences du modèle. Relance : les comptes de sampling changent un peu à chaque fois (c’est du hasard), greedy jamais.
✍️ À toi de jouer
- Pourquoi greedy donne-t-il exactement la même sortie à chaque exécution, alors que l’échantillonnage varie ?
- Sur 1000 tirages, environ combien de fois « France » (25 %) devrait-il sortir ?
- Dans quel cas concret préfèrerais-tu greedy, et dans quel cas l’échantillonnage ?
👉 Voir les réponses
- Greedy applique une règle sans hasard : « prends l’indice du maximum ». Pour une même liste de probabilités, le maximum est toujours le même, donc le choix aussi. L’échantillonnage tire au sort (pondéré) : le résultat dépend du hasard, il varie d’un tirage à l’autre.
- Environ 250 fois (25 % de 1000). Ce sera rarement exactement 250 : le hasard fait fluctuer autour de cette valeur, d’autant plus proche que le nombre de tirages est grand.
- Greedy pour une réponse factuelle, déterministe, reproductible (extraction d’info, réponse à une question fermée, code où l’on veut la solution la plus probable). Échantillonnage pour tout ce qui demande de la variété ou de la créativité (écriture, brainstorming, dialogue naturel).
Mini-résumé de la Partie A
- Greedy (
argmax) = toujours le plus probable → déterministe, mais répétitif. - Échantillonner = tirer au hasard pondéré par les probabilités → variété maîtrisée.
- Le choix greedy/sampling dépend du besoin : fiabilité vs créativité.
PARTIE B — La température : le curseur créativité (LE CŒUR)
L’échantillonnage brut respecte les probabilités du modèle. Mais on veut régler l’audace du tirage : le rendre plus prudent (coller aux mots très probables) ou plus aventureux (donner leur chance aux outsiders). Ce réglage, c’est la température. Si tu ne retiens qu’une chose du jour, c’est cette partie.
B.1 — L’idée : chauffer ou refroidir la distribution
❓ Question d’ouverture : comment rendre une liste de probabilités « plus tranchée » (le gagnant écrase tout) ou « plus égalitaire » (tout le monde a un peu sa chance), sans changer le modèle ?
🧮 Rappel maths ciblé (épisode 2, Partie 0.3)
Le softmax transforme des scores (logits) en probabilités : exponentielle de chaque score, puis chacun divisé par le total → parts sommant à 100 %. La température agit juste avant le softmax : on divise chaque logit par un nombre T (la température) avant d’appliquer le softmax. C’est tout le mécanisme.
Ce que fait T, concrètement
On divise les logits par T, puis softmax :
- T = 1 : rien ne change, c’est la distribution d’origine du modèle.
- T < 1 (ex. 0,5) : on divise par un petit nombre → les logits grandissent → le softmax accentue les écarts → la distribution devient plus tranchée (le mot dominant écrase les autres). On dit qu’on « refroidit » : plus prudent, plus déterministe.
- T > 1 (ex. 1,5) : on divise par un grand nombre → les logits se rapprochent → le softmax aplatit la distribution → les outsiders remontent. On « chauffe » : plus aventureux, plus créatif (mais risque d’incohérence).
- T → 0 : la distribution devient un pic sur le maximum → équivalent à greedy.
📌 Point clé : la température est un curseur de créativité. Basse (0,2-0,7) = fiable, factuel, répétitif ; moyenne (~0,8-1,0) = équilibré, naturel ; haute (1,2-2,0) = créatif, surprenant, parfois incohérent. T→0 = greedy.
L’analogie : la température au sens propre
Comme des molécules : froid = elles bougent peu, tout est figé et ordonné (distribution tranchée, choix prévisible) ; chaud = elles s’agitent, l’ordre se brouille (distribution aplatie, choix imprévisible). D’où le nom « température ».
B.2 — Voir la température déformer une distribution
🔬 Manip 2 — appliquer la température à la main
On reprend une distribution jouet et on regarde comment T la déforme. Crée j3_manip2_temperature.py :
# j3_manip2_temperature.py — l'effet de la température sur une distribution
import numpy as np

mots   = ["Paris", "France", "the", "Lyon", "banana"]
logits = np.array([3.0,     2.0,     1.0,   0.5,    -1.0])   # scores bruts du modèle

def softmax(x):
    e = np.exp(x - x.max())
    return e / e.sum()

def avec_temperature(logits, T):
    return softmax(logits / T)      # LE cœur : on divise les logits par T, puis softmax

for T in [0.1, 0.5, 1.0, 1.5, 3.0]:
    p = avec_temperature(logits, T)
    ligne = "  ".join(f"{m}={pr*100:4.1f}%" for m, pr in zip(mots, p))
    print(f"T={T:>3} | {ligne}")
Lance : uv run j3_manip2_temperature.py
✅ Checkpoint : observe la colonne « Paris ». À T=0.1, elle frôle 100 % (quasi greedy, tout le reste écrasé). À T=1.0, c’est la distribution naturelle. À T=3.0, les probabilités se rapprochent (« banana » lui-même remonte). Tu vois littéralement le curseur créativité agir : baisse T = concentration, monte T = dispersion. C’est exactement ce que fait le paramètre
temperatured’une API.
🔬 Manip 3 — l’effet sur le texte réellement tiré
Voir la distribution, c’est bien ; voir le texte qui en sort, c’est mieux. On échantillonne 20 mots à différentes températures. Crée j3_manip3_temp_sur_tirage.py :
# j3_manip3_temp_sur_tirage.py — mêmes probas, tirages à différentes températures
import numpy as np

mots   = ["Paris", "France", "the", "Lyon", "banana"]
logits = np.array([3.0, 2.0, 1.0, 0.5, -1.0])

def softmax(x):
    e = np.exp(x - x.max()); return e / e.sum()

for T in [0.3, 1.0, 2.0]:
    p = softmax(logits / T)
    tirage = np.random.choice(mots, size=20, p=p)   # 20 tirages avec cette température
    print(f"T={T} -> {' '.join(tirage)}")
Lance : uv run j3_manip3_temp_sur_tirage.py
✅ Checkpoint : à T=0.3, la suite est très dominée par « Paris » (peu de variété). À T=1.0, un mélange raisonnable. À T=2.0, « banana » et « Lyon » apparaissent souvent (variété… mais aussi n’importe quoi). Sur un vrai modèle, c’est exactement ce compromis que tu ajusteras : trop bas = ennuyeux, trop haut = incohérent.
🧵 « Paris » — premier élément de réponse
Sur notre fil rouge : à basse température, « The capital of France is » sortira quasi toujours « Paris » (ce qu’on veut pour un fait). Monter la température ferait remonter « Lyon » ou d’autres — inutile, voire faux, pour une question factuelle. Leçon : pour du factuel, température basse ; garde le curseur haut pour le créatif. La seconde moitié de la question (éviter plat ET charabia sur « Once upon a time ») trouvera sa réponse en Partie C avec top-k/top-p.
✍️ À toi de jouer
- Sans lancer : à T très basse (0,1), à quelle stratégie de l’épisode 1 l’échantillonnage devient-il équivalent ?
- Tu génères une histoire et le texte est plat, prévisible, répétitif. Tu montes ou tu baisses la température ?
- Ton modèle produit du charabia incohérent. Dans quel sens ajustes-tu la température ?
👉 Voir les réponses
- À greedy (
argmax). Quand T→0, le softmax concentre toute la probabilité sur le logit maximal : tirer « au hasard » dans une distribution qui vaut ~100 % sur un seul mot revient à toujours choisir ce mot. - Tu montes la température. Un texte plat vient d’une distribution trop concentrée sur les mots évidents : chauffer redonne leur chance aux mots moins probables et introduit de la variété.
- Tu baisses la température. Le charabia vient souvent d’une distribution trop aplatie où des mots improbables sont tirés : refroidir reconcentre le tirage sur des choix cohérents.
Mini-résumé de la Partie B
- La température divise les logits avant le softmax : elle déforme la distribution.
- T basse = tranchée (fiable, répétitif) ; T haute = aplatie (créatif, risqué) ; T→0 = greedy.
- C’est le principal curseur « fiabilité ↔ créativité » d’un modèle.
PARTIE C — Top-k et top-p : filtrer avant de tirer
La température déforme toute la distribution, mais laisse une faille : même aplatie, elle garde une petite chance de tirer un mot absurde (la longue traîne de mots très improbables). Top-k et top-p corrigent ça en coupant les mauvais candidats avant le tirage. Partie importante, mais tu peux la garder pour une 2ᵉ session.
C.1 — Top-k : ne garder que les k meilleurs
❓ Question d’ouverture : si un modèle hésite entre 50 000 mots mais que seuls 5 sont pertinents, faut-il laisser une chance aux 49 995 autres ?
L’idée
Top-k : on ne garde que les k mots les plus probables, on met les autres à zéro, puis on renormalise (pour que les k restants somment à 100 %) et on tire parmi eux. Avec k=5, seuls les 5 meilleurs candidats sont éligibles ; la longue traîne d’absurdités est éliminée d’office.
L’analogie : la présélection
Comme un jury qui ne retient que les 5 meilleurs candidats avant l’entretien final. Les 49 995 autres sont écartés d’emblée — inutile de leur laisser une chance résiduelle.
🔬 Manip 4 — top-k à la main
Crée j3_manip4_topk.py :
# j3_manip4_topk.py — ne garder que les k meilleurs, puis renormaliser
import numpy as np

mots   = ["Paris", "France", "the", "Lyon", "banana", "xyz"]
probas = np.array([0.50, 0.25, 0.10, 0.08, 0.05, 0.02])

def top_k(probas, k):
    idx_tries = np.argsort(probas)[::-1]     # indices du + probable au - probable
    garder = idx_tries[:k]                   # on garde les k premiers
    filtre = np.zeros_like(probas)
    filtre[garder] = probas[garder]          # les autres restent à 0
    return filtre / filtre.sum()             # renormalisation -> somme = 1

for k in [1, 2, 3]:
    p = top_k(probas, k)
    ligne = "  ".join(f"{m}={pr*100:4.1f}%" for m, pr in zip(mots, p))
    print(f"k={k} | {ligne}")
Lance : uv run j3_manip4_topk.py
✅ Checkpoint : à k=1, toute la probabilité va à « Paris » (équivalent greedy). À k=2, seuls « Paris » et « France » restent, renormalisés à eux deux (~67 %/33 %). Les mots absurdes (« xyz », « banana ») sont éliminés dès qu’ils sortent du top-k. Tu vois le filtre couper la longue traîne.
La limite de top-k
k est fixe, mais les situations varient. Après « The capital of France is », un seul mot est correct (« Paris ») : k=5 laisse passer 4 mauvais candidats. Après « I feel », des dizaines de mots sont plausibles : k=5 en coupe trop. Un k fixe ne s’adapte pas au fait que le modèle soit sûr ou hésitant. D’où top-p.
C.2 — Top-p (nucleus) : garder juste assez de masse
❓ Question d’ouverture : plutôt que de fixer le nombre de candidats, peut-on fixer la quantité de probabilité à couvrir, et laisser le nombre s’ajuster tout seul ?
L’idée
Top-p (aussi appelé nucleus sampling) : on garde les mots les plus probables jusqu’à ce que leur probabilité cumulée atteigne p (ex. p=0,9 = 90 %), puis on jette le reste, on renormalise, et on tire. Le nombre de mots retenus s’adapte :
- modèle sûr (« Paris » à 95 %) → 1 seul mot suffit pour atteindre 90 %,
- modèle hésitant (probabilités étalées) → il en faut beaucoup.
L’analogie : remplir un panier jusqu’à un seuil
Tu ajoutes les candidats du plus probable au moins probable, en cumulant, et tu t’arrêtes dès que le panier contient 90 % de la « masse » de probabilité. Selon les cas, le panier contient 1 ou 30 mots — il s’ajuste à la confiance du modèle.
🔬 Manip 5 — top-p à la main
Crée j3_manip5_topp.py :
# j3_manip5_topp.py — garder les mots jusqu'à atteindre p% de probabilité cumulée
import numpy as np

def top_p(mots, probas, p):
    idx = np.argsort(probas)[::-1]           # du + au - probable
    cumul = 0.0
    garder = []
    for i in idx:
        garder.append(i)
        cumul += probas[i]
        if cumul >= p:                       # dès qu'on atteint le seuil p, on s'arrête
            break
    filtre = np.zeros_like(probas)
    filtre[garder] = probas[garder]
    return filtre / filtre.sum(), [mots[i] for i in garder]

# Cas 1 : modèle SÛR (un mot domine)
mots1 = ["Paris", "France", "the", "Lyon", "banana"]
p1    = np.array([0.92, 0.04, 0.02, 0.01, 0.01])
_, gardes1 = top_p(mots1, p1, 0.9)
print("Modèle sûr,     p=0.9 -> mots gardés :", gardes1)

# Cas 2 : modèle HÉSITANT (probabilités étalées)
mots2 = ["a", "b", "c", "d", "e", "f"]
p2    = np.array([0.25, 0.22, 0.20, 0.15, 0.10, 0.08])
_, gardes2 = top_p(mots2, p2, 0.9)
print("Modèle hésitant, p=0.9 -> mots gardés :", gardes2)
Lance : uv run j3_manip5_topp.py
✅ Checkpoint — le point clé de la partie : dans le cas « sûr », top-p ne garde qu’1 mot (« Paris » couvre déjà 92 % ≥ 90 %). Dans le cas « hésitant », il en garde 5 pour atteindre 90 %. Le même réglage p=0,9 s’adapte automatiquement à la confiance du modèle — c’est ce que top-k, avec son k fixe, ne sait pas faire. C’est pourquoi top-p est le réglage le plus utilisé en pratique.
🧵 « Paris » — la réponse complète à notre fil rouge
On peut maintenant répondre entièrement à la question du jour. Sur « The capital of France is » (modèle sûr), top-p ne retient que « Paris » : on ne tire jamais d’absurdité, même avec de l’échantillonnage. Sur « Once upon a time » (modèle hésitant), top-p élargit le panier : de la variété, mais bornée aux mots plausibles — donc ni plat ni charabia. En pratique, on combine température (ampleur de créativité) et top-p (garde-fou anti-absurdité) : c’est la recette qui évite les deux écueils.
✍️ À toi de jouer
- En une phrase, quelle est la différence fondamentale entre top-k et top-p ?
- Modèle très sûr (« Paris » à 95 %). Avec p=0,9, combien de mots top-p garde-t-il ? Et top-k avec k=5 ?
- Pourquoi combine-t-on souvent température et top-p, plutôt que l’un ou l’autre ?
👉 Voir les réponses
- Top-k garde un nombre fixe de mots (les k meilleurs) quelle que soit la situation ; top-p garde un nombre variable de mots, juste assez pour couvrir une quantité de probabilité p — il s’adapte à la confiance du modèle.
- Top-p ne garde qu’1 mot (« Paris » à 95 % dépasse déjà 90 %). Top-k avec k=5 garde 5 mots, dont 4 mauvais candidats qui n’auraient pas dû rester — d’où sa rigidité.
- Parce qu’ils jouent des rôles complémentaires : la température règle l’ampleur de la créativité (à quel point on aplatit la distribution), tandis que top-p pose un garde-fou qui élimine la longue traîne d’absurdités. Ensemble : créativité contrôlée sans dérapage incohérent.
Mini-résumé de la Partie C
- Top-k : garder les k meilleurs (nombre fixe), jeter le reste, renormaliser.
- Top-p (nucleus) : garder juste assez de mots pour couvrir p % (nombre variable, s’adapte).
- On combine souvent température + top-p : créativité réglable + garde-fou anti-absurdité.
PARTIE D — Bonus : sens les réglages sur un vrai modèle (GPU facultatif)
Jusqu’ici, sur des distributions jouets en CPU. Maintenant le moment satisfaisant : on reprend le modèle moderne vu à l’épisode 1 (Qwen2.5-1.5B) et on fait varier température / top-k / top-p sur de vraies générations. Tu vas sentir, sur du vrai texte, ce que chaque curseur change. Si tu as un GPU NVIDIA compatible CUDA, c’est fluide ; sinon, ça tourne en CPU — plus lentement, réduis alors
max_new_tokenspour garder des essais rapides.
D.1 — Rien de neuf à installer
On réutilise transformers + torch et le modèle Qwen déjà téléchargé à l’épisode 1. Si tu as un GPU, vérifie-le au besoin :
uv run manip5_gpu_check.py # doit afficher : CUDA disponible : True💡 Si
transformersn’est plus listé,uv add transformers. Le modèle Qwen est en cache depuis l’épisode 1 : pas de retéléchargement. Sans GPU, ignore la vérif — le code bascule seul en CPU.
D.2 — La température sur un vrai modèle
On génère la même suite à trois températures et on compare. Crée j3_manip6_temp_reelle.py :
# j3_manip6_temp_reelle.py — la température sur de vraies générations (Qwen)
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.float16 if device == "cuda" else torch.float32   # float16 : GPU ; float32 : CPU
nom = "Qwen/Qwen2.5-1.5B-Instruct"
tok = AutoTokenizer.from_pretrained(nom)
model = AutoModelForCausalLM.from_pretrained(nom, torch_dtype=dtype).to(device)

messages = [{"role": "user", "content": "Écris le début d'un conte, en une phrase."}]
entree = tok.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt").to(device)

for T in [0.2, 0.8, 1.5]:
    sortie = model.generate(
        entree,
        max_new_tokens=60,
        do_sample=True,          # do_sample=True = on ÉCHANTILLONNE (sinon greedy)
        temperature=T,           # notre curseur du jour
        top_p=1.0, top_k=0,      # on neutralise top-p/top-k pour isoler l'effet température
    )
    texte = tok.decode(sortie[0][entree.shape[1]:], skip_special_tokens=True)
    print(f"\n=== T={T} ===\n{texte}")
Lance : uv run j3_manip6_temp_reelle.py
✅ Checkpoint : à T=0.2, le début de conte est sage, convenu, presque toujours le même si tu relances. À T=0.8, il devient plus vivant et varié. À T=1.5, il part dans des directions surprenantes — parfois géniales, parfois bancales. Tu sens, sur du vrai texte, le compromis fiabilité/créativité que tu manipulais en abstrait en Partie B. Relance plusieurs fois : à T basse, peu de variété entre les runs ; à T haute, beaucoup.
D.3 — top-p en action
On fixe une température vive et on montre que top-p borne les dérapages. Crée j3_manip7_topp_reel.py :
# j3_manip7_topp_reel.py — top-p comme garde-fou à température élevée
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"
dtype = torch.float16 if device == "cuda" else torch.float32
nom = "Qwen/Qwen2.5-1.5B-Instruct"
tok = AutoTokenizer.from_pretrained(nom)
model = AutoModelForCausalLM.from_pretrained(nom, torch_dtype=dtype).to(device)

messages = [{"role": "user", "content": "Donne une idée originale de nom pour un café."}]
entree = tok.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt").to(device)

for p in [1.0, 0.9, 0.5]:
    sortie = model.generate(
        entree, max_new_tokens=40, do_sample=True,
        temperature=1.3,         # température volontairement élevée
        top_p=p,                 # on fait varier le garde-fou
    )
    texte = tok.decode(sortie[0][entree.shape[1]:], skip_special_tokens=True)
    print(f"\n=== top_p={p} (T=1.3) ===\n{texte}")
Lance : uv run j3_manip7_topp_reel.py
✅ Checkpoint : à top_p=1.0 (aucun filtre) et T=1.3, la sortie peut déraper (mots hors-sujet). À top_p=0.9, elle reste créative mais cohérente. À top_p=0.5, elle se resserre sur les idées les plus sûres. Tu vois le garde-fou fonctionner : top-p coupe la longue traîne d’absurdités que la température élevée aurait laissé passer. C’est la combinaison gagnante de la Partie C, sur un vrai modèle.
💡 Si tu as un GPU, observe-le dans un second terminal :
watch -n 1 nvidia-smi. Même réflexedevice+.to(device)que les épisodes précédents. Les paramètres de sampling ne coûtent presque rien : c’est le modèle qui travaille, pas le tirage. Sans GPU, tout tourne en CPU (plus lentement).
✍️ À toi de jouer
- Dans
generate(), à quoi sertdo_sample=True? Que se passe-t-il si tu le mets àFalse(teste-le) ? - Tu veux des réponses factuelles et reproductibles (ex. un assistant qui répond à des questions fermées). Quels réglages choisis-tu (do_sample, temperature) ?
- Reprends
j3_manip6avec le prompt « Explique ce qu’est un token. » à T=0.2 puis T=1.5. Pour une explication technique, quelle température préfères-tu et pourquoi ?
👉 Voir les réponses
do_sample=Trueactive l’échantillonnage (tirage pondéré, donc température/top-p/top-k s’appliquent). Avecdo_sample=False,generate()repasse en greedy (argmax) : sortie déterministe, et les paramètres temperature/top-p sont ignorés. En le testant, tu obtiens toujours la même génération.do_sample=False(greedy) oudo_sample=Trueavec une température basse (ex. 0,2). Pour du factuel reproductible, greedy est le plus sûr : même question → même réponse, et on prend le mot le plus probable.- Pour une explication technique, T basse (0,2) : on veut de la précision et de la cohérence, pas de la fantaisie. À T=1.5, l’explication risque de partir en formulations imprécises ou erronées. La créativité est utile pour écrire, pas pour expliquer un fait.
Mini-résumé de la Partie D
- Dans
generate():do_sample=Trueactive le sampling ;temperature,top_p,top_kle règlent. - Sur un vrai modèle, T basse = fiable, T haute = créatif, top-p = garde-fou anti-dérapage.
- Recette usuelle : do_sample=True + température modérée + top_p ~0,9 pour du créatif contrôlé ; greedy ou T basse pour du factuel.
⚠️ Pièges fréquents (récapitulatif transversal)
| Piège | Pourquoi c’est dangereux | Le bon réflexe |
|---|---|---|
Oublier do_sample=True puis régler temperature | Sans sampling, temperature est ignorée (greedy) | Pour que T/top-p agissent : do_sample=True |
| Croire que la température change le modèle | Elle ne touche que la distribution finale | T déforme la liste de probabilités, rien d’autre |
| Monter la température pour « plus d’intelligence » | Haute T = plus de hasard, pas plus de justesse | T haute = créativité/risque, pas qualité factuelle |
| Confondre top-k et top-p | k = nombre fixe ; p = masse variable | top-p s’adapte à la confiance du modèle |
| Mettre top-p=1.0 avec T très élevée | Aucun garde-fou → risque de charabia | Associer T vive à un top-p ~0,9 |
| Chercher LA valeur parfaite universelle | Le bon réglage dépend de la tâche | Factuel → bas ; créatif → plus haut ; on ajuste |
Lancer les manips sans uv run | ModuleNotFoundError / mauvais environnement | Toujours uv run <script>.py depuis llm-formation/ |
🔁 Récap final synthétique
   LA LISTE DE PROBABILITÉS NE CHANGE PAS — SEULE LA RÈGLE DE TIRAGE CHANGE
                                    │
     ┌──────────────┬──────────────┴──────────────┬──────────────┐
     ▼              ▼                              ▼              ▼
  PARTIE A       PARTIE B                       PARTIE C       PARTIE D
 greedy vs       la TEMPÉRATURE                 top-k / top-p  sur un vrai
 sampling        (le cœur)                      (garde-fous)   modèle (Qwen)
     │              │                              │              │
 argmax =        logits / T  puis softmax        k = nombre     do_sample=True
 déterministe    T bas  -> tranchée (fiable)     FIXE           temperature
 sampling =      T haut -> aplatie (créatif)     p = masse      top_p ~0,9
 hasard pondéré  T→0    -> greedy                VARIABLE (s'adapte)  = combo gagnant

   Recette : factuel -> greedy / T basse ;  créatif -> T modérée + top_p ~0,9
💻 Partie D (bonus) : sur ton GPU (ou en CPU), avec Qwen, tu as senti les curseurs sur du vrai texte — T basse sage, T haute surprenante, top-p en garde-fou. Mêmes réglages que les API que tu rencontreras plus loin dans la série.
🧠 Auto-évaluation (fais-la vraiment) : sans relire, peux-tu (a) dire ce que fait T→0 et pourquoi, (b) expliquer la différence top-k / top-p en une phrase, et (c) donner les réglages pour une réponse factuelle vs une histoire créative ? Si un point coince, retourne à la partie concernée avant le quiz.
✅ Quiz de validation
- Quelle est la différence entre greedy et échantillonnage, et pourquoi le second rend un modèle « créatif » ?
- Que fait la température T=0,3 à une distribution ? Et T=2,0 ? À quelle stratégie T→0 équivaut-il ?
- Explique la différence entre top-k et top-p, et pourquoi top-p s’adapte mieux à la confiance du modèle.
- Dans
generate(), pourquoi réglertemperaturesansdo_sample=Truen’a-t-il aucun effet ? - Ton modèle génère un texte plat et répétitif, puis (après réglage) un charabia incohérent. Quel curseur as-tu bougé, et dans quel sens à chaque fois ?
👉 Voir le corrigé
- Greedy prend toujours le mot le plus probable → sortie déterministe et répétitive. L’échantillonnage tire un mot au hasard pondéré par les probabilités → il introduit de la variété. Cette variété maîtrisée (les mots probables sortent plus souvent, mais pas toujours) produit l’effet de « créativité » : le modèle explore des suites différentes à chaque génération.
- T=0,3 (< 1) accentue les écarts : la distribution devient plus tranchée, le mot dominant écrase les autres (plus fiable, plus répétitif). T=2,0 (> 1) aplatit la distribution : les outsiders remontent (plus créatif, plus risqué). T→0 équivaut à greedy (toute la probabilité se concentre sur le maximum).
- Top-k garde un nombre fixe de mots (les k meilleurs), indépendamment de la situation. Top-p garde juste assez de mots pour couvrir une quantité de probabilité p, donc un nombre variable. Top-p s’adapte mieux car, quand le modèle est sûr, il ne garde qu’un mot, et quand il hésite, il en garde beaucoup — là où un k fixe laisse passer des absurdités ou coupe trop, selon les cas.
- Parce que sans
do_sample=True,generate()fait du greedy (il prend l’argmax). La température ne sert qu’à déformer une distribution avant un tirage aléatoire ; s’il n’y a pas de tirage, la déformation n’a aucun effet observable. Il faut activer l’échantillonnage pour que temperature (et top-p/top-k) comptent. - Texte plat → j’ai monté la température (distribution trop concentrée : chauffer ajoute de la variété). Puis charabia → la température était trop haute : je la baisse (distribution trop aplatie tirant des mots incohérents : refroidir reconcentre). Le bon réglage est un équilibre entre les deux, souvent avec un top-p ~0,9 comme garde-fou.
🧠 Bilan objectifs : reprends les 5 objectifs du début. Pour chacun, peux-tu dire « oui, je sais faire » ? Si un seul te résiste, tu sais quelle section relire.
🔧 Si ça coince (dépannage)
« Régler temperature ne change rien. »
Tu as sûrement oublié do_sample=True : sans lui, generate() fait du greedy et ignore la température. Ajoute-le.
« uv run : ModuleNotFoundError (numpy / transformers). »
Dépendance absente ou lancement sans uv run. Depuis llm-formation/, refais uv add <paquet> et lance avec uv run <script>.py.
« torch.cuda.is_available() renvoie False. »
Version CPU de torch — pas grave : les Parties A-C tournent en CPU, et la Partie D aussi (plus lentement). Si tu veux un GPU NVIDIA, réinstalle la version GPU (épisode 1, Partie D) : uv add torch --index pytorch-cuda=https://download.pytorch.org/whl/cu124, puis revérifie avec uv run manip5_gpu_check.py.
« Les générations Qwen sont lentes. »
Sur GPU, la première génération après chargement a un peu de latence (mise en place), puis c’est rapide ; vérifie que le modèle est bien sur GPU et chargé en float16. En CPU, c’est normalement lent : réduis max_new_tokens (ex. 20-30) et le nombre de valeurs testées pour garder des essais courts.
« Un warning sur temperature/top_p quand do_sample=False. »
Normal : transformers prévient que ces paramètres sont sans effet en greedy. Ignore, ou mets do_sample=True.
« Warning sur l’attention mask / pad token. » Bénin pour nos usages. Si le script produit son texte, ignore-le.
💡 Réflexe général : copie le message d’erreur exact dans un moteur de recherche. Et reviens m’en parler si besoin.
📌 Mémo des commandes
uvdu jour :
cd llm-formation— se placer dans le projetuv add numpy transformers— dépendances du jouruv run <script>.py— lancer un script- (option GPU, si tu en as un)
uv add torch --index pytorch-cuda=https://download.pytorch.org/whl/cu124
🚀 Pour aller plus loin
🔄 Autre approche (le même sujet, un autre angle)
| Ressource | Type | En quoi l’angle diffère | Effort |
|---|---|---|---|
| Hugging Face — « How to generate text » (blog huggingface.co) | Article + code | LE tutoriel de référence sur greedy/beam/top-k/top-p, avec exemples exécutables | Lecture + pratique |
| « The Curious Case of Neural Text Degeneration » (arxiv.org/abs/1904.09751) | Article de recherche | L’article qui a introduit le top-p (nucleus) : pourquoi la longue traîne dégrade le texte | Lecture exigeante |
| OpenAI / Anthropic — doc des paramètres d’API (platform.openai.com / docs.anthropic.com) | Doc officielle | Voir temperature/top-p côté API, tels que tu les utiliseras plus loin dans la série | Lecture |
🧩 Complémentaire (élargir le périmètre)
| Ressource | Type | Le lien concret avec aujourd’hui | Effort |
|---|---|---|---|
Doc transformers — GenerationConfig (huggingface.co/docs) | Doc officielle | Tous les paramètres de generate() : beam search, repetition_penalty, etc. | Lecture |
| « Repetition penalty » et anti-répétition (blog HF) | Article | Autres leviers contre le texte répétitif, au-delà de la température | Lecture |
| Prompt playgrounds (platform.openai.com/playground) | Outil web | Bouger température/top-p en direct sur un vrai modèle, sans coder | À manipuler |
🔬 Approfondissement (creuser le sujet lui-même)
| Ressource | Type | Niveau / prérequis | Effort |
|---|---|---|---|
| Andrej Karpathy — « Let’s build GPT » (section génération) | Vidéo + code | Intermédiaire ; implémente le sampling avec température dans la boucle | Pratique |
| « Locally Typical Sampling », « Mirostat » (arxiv) | Articles | Avancé ; méthodes d’échantillonnage au-delà de top-k/top-p | Lecture exigeante |
Doc transformers — Streaming (huggingface.co/docs) | Doc | Générer token par token en direct (utile pour le chatbot qui clôt la série) | Lecture + pratique |
📈 Suggestion de séquence d’apprentissage
- Aujourd’hui d’abord : fais les manips 1-3 (greedy vs sampling, puis température) jusqu’à voir la distribution se déformer. C’est le déclic.
- Fais la Partie C (top-k/top-p) et retiens surtout pourquoi top-p s’adapte (manip 5, cas sûr vs hésitant).
- Fais la Partie D : sentir les curseurs sur Qwen ancre tout le reste.
- Lis le blog HF « How to generate text » pour consolider, puis survole l’article nucleus si tu veux le fond.
- Garde le playground OpenAI/Anthropic sous la main : c’est le pont direct vers les API à venir dans la série.
➡️ Prochain épisode — Servir un modèle en local : tu comprends maintenant tout le pipeline d’un LLM, de l’entrée à la génération réglée (les trois premiers épisodes). Il est temps de quitter les scripts jouets et de faire tourner de vrais modèles proprement en local. Au prochain épisode : installer et servir des modèles locaux (via Hugging Face et un serveur compatible OpenAI), pour préparer les premiers appels d’API qui suivront. Ton GPU va enfin donner sa pleine mesure (et les modèles légers resteront jouables en CPU). Reviens avec tes manips faites et tes questions.